El Pentium que dividía mal y la respuesta de 475 millones
El 30 de octubre de 1994 un profesor de matemáticas avisó por correo de que el Pentium fallaba al dividir, en un caso entre miles de millones. El fallo era raro; lo que lo agravó fue pedirle al cliente que demostrara que merecía un procesador que funcionase.
Hoy, 30 de octubre, se cumplen 32 años de un correo electrónico que acabó en una factura de 475 millones de dólares. No la causó el correo, y quien lo escribió no quería hacer daño a nadie.
El 30 de octubre de 1994, Thomas Nicely, profesor de matemáticas en el Lynchburg College, envió un mensaje a un grupo de personas y organizaciones contando que el procesador Pentium de Intel dividía mal.
Seis días antes se lo había comunicado a Intel.
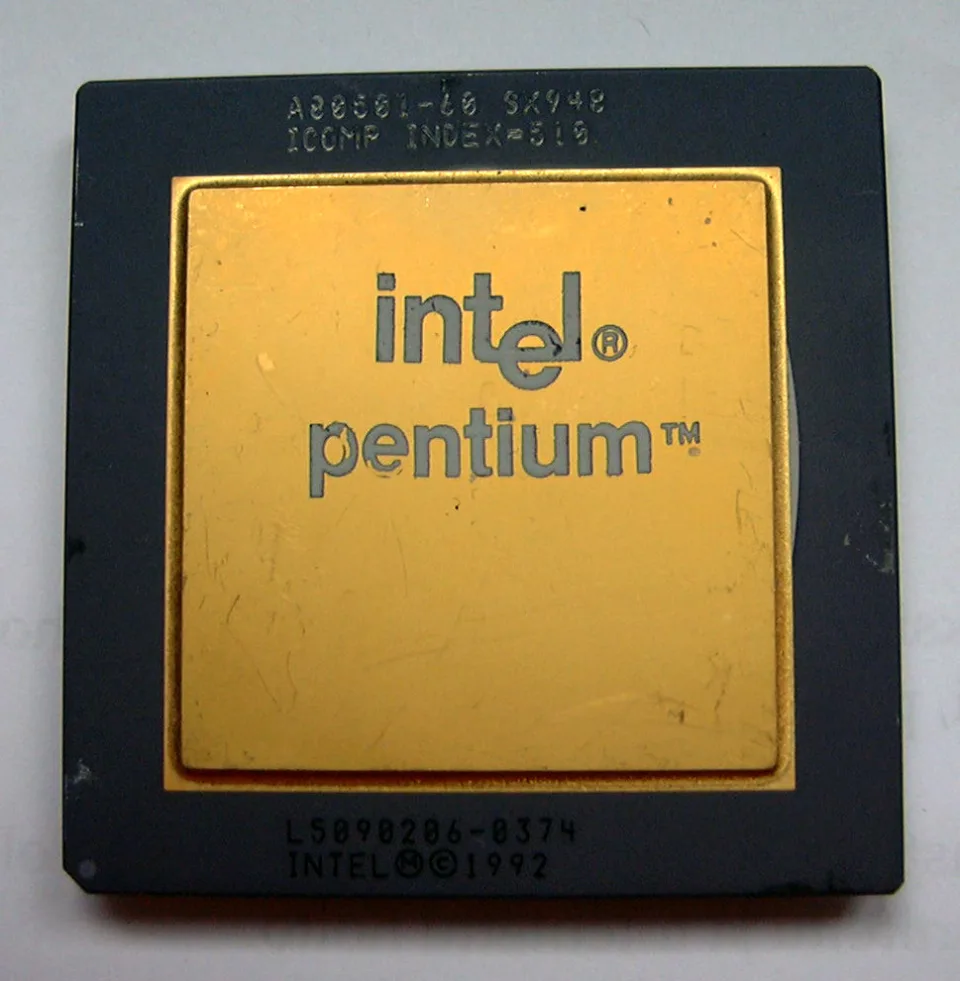
Un Intel Pentium a 60 MHz, una de las versiones con el fallo de la división. Foto de Stonda, en dominio público, vía Wikimedia Commons.
El fallo era pequeño de verdad
Conviene decirlo, porque es lo que hace interesante el caso.
El algoritmo de división en coma flotante del Pentium usaba una tabla de consulta precalculada. En esa tabla, unas pocas entradas de más de un millar estaban vacías por un error en la generación. El resultado: ciertas divisiones muy concretas devolvían un valor con un pequeño error a partir de determinado decimal.
Las estimaciones de la época hablaban de algo del orden de un caso entre miles de millones de divisiones con operandos aleatorios. Una frecuencia bajísima, pero que por sí sola no decía qué riesgo corría un cálculo concreto: eso dependía de cuántas divisiones hiciera y con qué números.
Nicely lo encontró porque llevaba meses calculando números primos gemelos y le salían inconsistencias que no cuadraban. Descartó su propio código, descartó el compilador, descartó la biblioteca matemática, descartó el sistema. Le costó meses llegar a la única explicación que quedaba, que era la que nadie considera: que el procesador estuviera mal.
Cuando ya no le quedaba nada más que descartar, escribió a Intel.
Lo que hundió esto no fue el bug
Intel conocía el problema. Lo había detectado internamente y ya lo estaba corrigiendo en la fabricación. Cuando el asunto se hizo público, la respuesta pública fue esencialmente esta:
- El error es estadísticamente insignificante.
- La inmensa mayoría de los usuarios no lo encontrará jamás.
- Sustituiremos el procesador a quien demuestre que su trabajo requiere ese nivel de precisión.
Intel defendía esa política con argumentos estadísticos. Los tres puntos, juntos, fueron un desastre.
Porque el punto tres dice, sin decirlo: hemos vendido un producto que hace mal una operación aritmética elemental, y ahora te toca a ti justificar ante nosotros que mereces uno que funcione.
Esa frase no se discute con probabilidades. La gente no estaba pidiendo un cálculo de riesgo, estaba pidiendo que la división diera bien.
El asunto escaló durante noviembre en foros, listas de correo y prensa. Circularon chistes matemáticos por todas partes. Y el 12 de diciembre, IBM —que fabricaba y vendía ordenadores con esos procesadores— anunció que suspendía los envíos. Había hecho sus propias cuentas: con una hoja de cálculo en uso normal, un usuario podía tropezar con el error cada 24 días. Intel hablaba de una vez cada veintisiete mil años. Las dos cifras dependían de lo que cada uno suponía sobre los números que se dividen.
Ahí se acabó la discusión estadística. El 20 de diciembre, Intel pasó de exigir una justificación a ofrecer el cambio del procesador afectado a cualquiera que lo solicitara. En sus cuentas del cuarto trimestre de 1994, presentadas en enero, anotó un cargo de 475 millones de dólares antes de impuestos para cubrir la sustitución de los chips y la baja de las existencias.
La factura del punto tres
Lo que quiero que se lleve alguien de aquí es esto: el fallo era poco frecuente, y la respuesta inicial lo convirtió en un problema de confianza. Intel acabó haciendo exactamente lo que el punto tres pretendía evitar, cambiar el procesador sin pedir explicaciones, pero tarde y después de semanas discutiendo con sus clientes.
Cuánto habría costado responder bien desde el principio no lo sabe nadie. Lo que sí se sabe es que la condición del punto tres no aguantó.
Y la distinción no es histórica, es de cada semana:
- «Ese error solo le pasa a un 0,1 % de los usuarios.» Si tienes doscientos mil usuarios, ese 0,1 % son doscientas personas, y basta con que unas pocas lo cuenten en público.
- «Es un caso muy raro.» Raro significa que a quien le pasa está solo, no que no pase.
- «Solo afecta si tienes la configuración X.» La persona con la configuración X descubre además que se lo dices como si fuera culpa suya.
- «Técnicamente el sistema funciona según lo especificado.» Es la frase que más rápido convierte un problema técnico en un problema de relación.
El error de razonamiento es el mismo siempre: se calcula la probabilidad agregada y se responde a una persona concreta con ella. Para el conjunto, es un 0,1 %. Para quien te escribe, es el 100 %.
Y luego está cómo se trata a quien avisa
Nicely no era un adversario. Era un cliente que había dedicado meses de su tiempo, gratis, a aislar un fallo del producto de otro con una precisión que ya la quisieran muchos informes internos.
Entre que se lo dijo a Intel y que se lo contó a otros investigadores pasaron seis días.
No voy a reconstruir aquí aquellos seis días. A mí este caso me hace pensar en cómo recibimos los avisos de fallos: quien ha dedicado tiempo a aislar un problema necesita una respuesta útil, aunque todavía no tengamos una solución. Si no la recibe, es razonable que busque a otros que puedan comprobarlo.
Lo que hay que tener montado, y casi nadie tiene:
- Un sitio visible donde reportar un fallo, que no sea el formulario de contacto comercial ni un chat con un bot que ofrece artículos de ayuda.
- Un acuse de recibo de una persona en menos de 48 horas. No hace falta la solución: hace falta que conste que hay alguien al otro lado.
- Un plazo comprometido, aunque sea largo. «Lo miramos en el ciclo de noviembre» es infinitamente mejor que el silencio.
- Y crédito público a quien lo encontró, si acepta. Cuesta cero euros y le dice a quien avisó que su trabajo ha servido.
Cuando llega el momento de responder a un problema real, lo que se ha preparado antes es lo único que hay. En una crisis nadie improvisa bien.
Una nota sobre confiar en la capa de abajo
Hay un último detalle que conviene tener presente, y que emparenta este caso con la sonda que se perdió por un desajuste de unidades o con el servidor que ejecutaba código de 2003.
Nicely tardó meses en llegar a la hipótesis correcta porque el procesador es la última cosa que uno sospecha. Damos por buena la capa de abajo por definición: el compilador, la biblioteca estándar, el sistema de ficheros, el reloj de la máquina, el motor de la base de datos.
Casi siempre es lo correcto. La capa de abajo suele estar bien y sospechar de ella es una excelente forma de perder una tarde.
Pero «casi siempre» no es «siempre», y hay una señal que merece la pena reconocer: cuando llevas horas y todas las explicaciones razonables están descartadas, la hipótesis absurda pasa a ser la siguiente en la lista. No la primera. La siguiente.
Feliz aniversario
Cuatro cosas para hoy:
- Revisa el último «no reproducible» de tu sistema de incidencias. ¿Faltaban datos o se cerró sin investigar lo suficiente? Alguien lo vio.
- Comprueba cuánto tarda tu organización en responder a alguien que reporta un fallo. Con datos, no con la impresión que tienes.
- Revisa la última respuesta que disteis a un caso raro. Léela como si fueras el que la recibe.
- No uses «solo afecta a un pequeño porcentaje» como única respuesta a quien está sufriendo el fallo. Ese porcentaje sirve para priorizar; para contestar a una persona, no.
(Y si alguna vez te ves obligado a explicar a un cliente por qué su caso es estadísticamente despreciable, párate: eso ya lo intentó alguien en 1994 con muchísimos más abogados que tú.)
Preguntas frecuentes
¿En qué consistía el bug FDIV del Pentium?
El algoritmo de división en coma flotante del procesador utilizaba una tabla de valores precalculados en la que un pequeño número de entradas había quedado sin rellenar por un error en su generación. Como consecuencia, determinadas divisiones devolvían un resultado con una desviación a partir de cierta cifra decimal. Las estimaciones contemporáneas situaban su frecuencia en torno a un caso entre miles de millones de operaciones con operandos aleatorios.
¿Cómo se descubrió el fallo?
Thomas Nicely, profesor de matemáticas, detectó inconsistencias mientras realizaba cálculos relacionados con números primos gemelos. Antes de atribuirlas al procesador descartó sucesivamente su propio programa, el compilador, las bibliotecas matemáticas y el entorno de ejecución, proceso que le ocupó varios meses. Comunicó el hallazgo a Intel el 24 de octubre de 1994 y el 30 de octubre lo contó por correo electrónico a otros investigadores, pidiéndoles que lo comprobaran. La prensa lo recogió a partir del 7 de noviembre.
¿Por qué la respuesta de Intel resultó tan perjudicial?
Porque combinó la minimización estadística del problema con una política de sustitución que exigía al usuario acreditar que su actividad requería el nivel de precisión afectado. Esa condición trasladaba al cliente la responsabilidad de justificar la reparación de un producto defectuoso, lo que transformó una cuestión técnica menor en un conflicto de confianza. La controversia se cerró después de que un gran fabricante de equipos suspendiera sus envíos y la compañía ofreciera el cambio a cualquiera que lo solicitara.
¿Cuál fue el coste final del incidente?
Intel imputó al cuarto trimestre de 1994 un cargo antes de impuestos de 475 millones de dólares para cubrir la sustitución de los procesadores afectados y la baja de existencias, después de anunciar el 20 de diciembre que cambiaría el chip a cualquiera que lo solicitara. Es un cargo contable relacionado con el problema, no una medida exacta de lo que costó la forma de responder.
¿Qué debe incluir un canal adecuado de comunicación de fallos?
Un punto de entrada visible y diferenciado del contacto comercial, un acuse de recibo emitido por una persona en un plazo breve, un compromiso explícito de plazo de análisis aunque sea amplio, y el reconocimiento público de la autoría del hallazgo cuando quien informa lo acepte. El objetivo es evitar que el esfuerzo invertido por quien detecta el problema quede sin respuesta, situación que conduce con frecuencia a su difusión pública.
Otras noticias

El primer mensaje de internet fue «LO» y luego se cayó todo
El 29 de octubre de 1969, hacia las 22:30, un estudiante de UCLA intentó escribir «login» en un ordenador de Stanford. Llegaron la ele y la o, y a la ge se cayó el sistema. Lo verificaban por teléfono, letra a letra: un ejemplo temprano de comunicación fuera de banda.
Leer más →
Windows XP y el problema de durar demasiado bien
Salió el 25 de octubre de 2001 y aguantó casi doce años y medio de soporte, con más de una cuarta parte de los escritorios el mes que se lo cortaron. Duró porque era suficiente, porque su sucesor tardó y, sobre todo, porque acabó incrustado en máquinas con ciclo de vida de quince años.
Leer más →
Ada Lovelace fue mucho más que «la primera programadora»
Hoy es el Ada Lovelace Day. La Nota G de 1843 se cita como el primer programa, y esa etiqueta se queda corta. Lo mejor de sus notas es otra cosa: dejó escrito que una máquina programable puede trabajar con algo más que cantidades, y planteó la pregunta que seguimos haciéndole a la IA.
Leer más →El blog, día a día
¿Te ha resultado útil o quieres comentar algo?
Hablemos →