45 minutos y 440 millones: el despliegue de Knight Capital
El 1 de agosto de 2012, Knight Capital tenía código nuevo en siete de sus ocho servidores y una bandera reutilizada que despertó por accidente un programa de pruebas sin uso desde 2003. En cuarenta y cinco minutos perdió más de lo que valía la empresa.
Hoy, 1 de agosto, se cumplen años de uno de los despliegues más caros y destructivos de la historia del software.
El 1 de agosto de 2012, a las 9:30 de la mañana en Nueva York, sonó la campana de apertura del NYSE. Cuarenta y cinco minutos después, Knight Capital —uno de los mayores creadores de mercado de Estados Unidos— había ejecutado más de cuatro millones de operaciones sobre 154 valores: una posición larga de unos 3.500 millones de dólares en 80 de ellos y una corta de unos 3.150 millones en los otros 74. El expediente de la SEC cifra la pérdida en más de 460 millones de dólares.
Para dar la escala: era más que la capitalización de la propia empresa. En cuarenta y cinco minutos, un programa gastó la compañía entera y siguió gastando.
No hubo intrusión, ni sabotaje, ni un algoritmo demasiado listo. Hubo un despliegue.
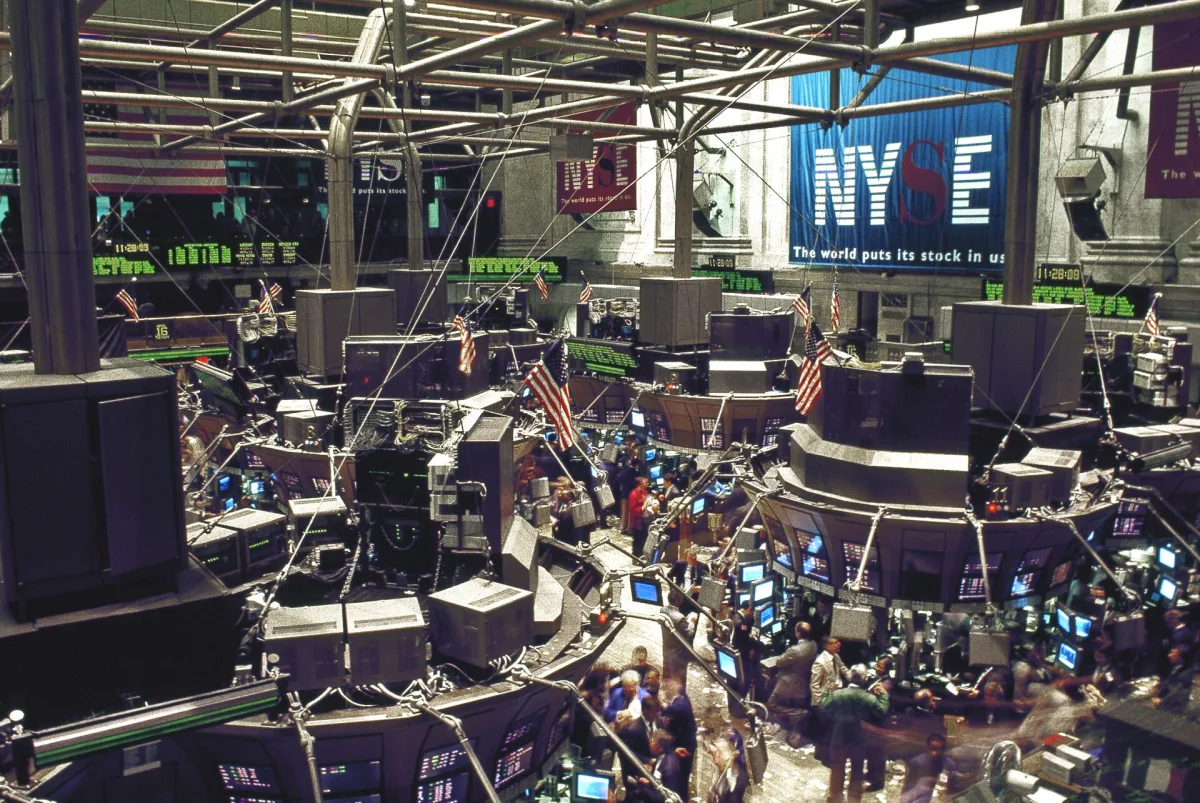
El parqué de la Bolsa de Nueva York. Foto: Carol M. Highsmith, dominio público, vía Wikimedia Commons.
Un servidor de ocho
Ese día entraba en funcionamiento un programa nuevo del NYSE, el Retail Liquidity Program. Knight tenía que adaptar SMARS, su sistema de enrutado de órdenes, así que preparó código nuevo y empezó a desplegarlo el 27 de julio, por fases y en producción.
A mano. Servidor por servidor. Eran ocho.
En siete quedó el código nuevo. En el octavo, no, y nadie lo revisó: la SEC deja escrito que Knight no tenía un segundo técnico verificando el despliegue ni un procedimiento escrito que lo exigiera.
Aquí está el detalle que convierte un error de despliegue rutinario en una catástrofe: para activar la funcionalidad nueva, los desarrolladores reutilizaron una bandera de configuración que ya existía. Una que en su día encendía otra cosa.
El muerto que seguía en el sótano
Esa otra cosa se llamaba Power Peg. Era código de pruebas de principios de los 2000, sin uso desde al menos 2003. Retirado, no borrado: siguió ahí, en los servidores, durante nueve años, esperando que alguien levantara su bandera.
Y Power Peg hacía lo que hace un programa de pruebas: comprar caro y vender barato a toda velocidad, sin ánimo de ganar dinero, solo para generar movimiento. En 2005, además, Knight movió a otro punto del sistema el contador que limitaba cuántas órdenes podía acumular. Nadie comprobó cómo le afectaba eso, porque el código estaba muerto.
Así que en aquel octavo servidor, la bandera nueva encendió al muerto. Y el muerto se puso a comprar caro y vender barato con dinero real, contra el mercado real, sin límite acumulado.
El código muerto no existe. Existe el código dormido. Y sobrevive por la misma razón que todo lo demás que no se toca: porque nadie tiene asignado el trabajo aburrido de quitarlo.
El rollback que multiplicó el incendio
Los cuarenta y cinco minutos siguientes son la parte que de verdad conviene leer despacio, porque es la parte que se repite en incidentes mucho más pequeños que este.
El equipo detectó que algo iba muy mal, identificó el despliegue reciente como la causa y tomó la decisión que parece obvia y suele ser la correcta: revertir el cambio.
Desinstalaron el código nuevo de los siete servidores donde sí se había instalado.
Con lo cual los ocho pasaron a tener el código viejo. Y la bandera seguía levantada. Y ahora eran ocho servidores ejecutando Power Peg en lugar de uno.
Deshacer sin entender no es deshacer: es apostar. Salió mal.
Los 97 correos que nadie leyó
Antes de la apertura, el sistema había enviado 97 correos electrónicos a personal técnico avisando de errores en el enrutado de órdenes.
Los generaba un sistema interno llamado BNET, mencionaban SMARS y describían un error concreto: «Power Peg disabled». Pero no estaban diseñados como alertas, sino como mensajes informativos del mismo tipo que ese sistema mandaba a diario, y la SEC señala que el personal de Knight no solía revisarlos. Nada los distinguía del ruido de una mañana normal.
Esto que te suena:
- El canal de Slack donde el bot escupe cada excepción y que todo el mundo tiene silenciado.
- Los 400 correos de «cron completado correctamente» entre los que vive un «cron completado con errores».
- El panel con doce indicadores en ámbar que llevan ocho meses en ámbar.
- La alerta de disco al 90 % que se ignora porque el 90 % «es lo normal en ese servidor».
Un aviso que se emite constantemente acaba informando de muy poco, aunque el día que traiga algo grave lo traiga igual: el problema es que ya nadie está mirando. Pregúntale a cualquiera que haya estado de guardia cuántas de las alertas que le despertaron el año pasado exigían despertarse.
Lo que no había: un interruptor
Cuarenta y cinco minutos es muchísimo tiempo. Es tiempo de sobra para apagar algo. La pregunta incómoda es por qué no se apagó antes, y lo que la SEC dejó escrito es que Knight no tenía controles ni procedimientos adecuados para detener aquello: ni límites de riesgo previos al envío de órdenes ni un mecanismo preparado para cortar la actividad errónea.
No existía un botón que dijera «deja de mandar órdenes al mercado». Existía una arquitectura donde parar significaba decidir sobre la marcha qué componente matar y en qué orden.
En una emergencia, el coste de equivocarse parando tiene que ser muy inferior al coste de no parar. Si no lo es, tu sistema no tiene freno: tiene un debate.
La factura
Knight Capital sobrevivió unos días. El 6 de agosto aceptó un rescate de 400 millones que diluyó a los accionistas hasta casi hacerlos desaparecer, y en julio de 2013 la compañía se fusionó con Getco. En octubre de ese año la SEC le impuso además una multa de 12 millones de dólares por incumplir la norma de acceso al mercado: fue la primera sanción dictada al amparo de esa regla.
Lo llamativo del expediente no es la cifra. Es que ninguno de los fallos que lo provocaron requería un experto para verlo. Requerían tiempo, y el tiempo se había ido a otra parte.
Cuatro cosas que puedes mirar hoy
- Busca tu Power Peg. Un
grepde las banderas de configuración de tu aplicación y una pregunta por cada una: ¿qué enciende esto exactamente, y cuándo estuvo encendida por última vez? Lo que lleve años apagado no se borra a ciegas: se revisa, se justifica si sigue haciendo falta, se prueba su retirada y se elimina de forma controlada, código y bandera a la vez. - Cuenta los pasos manuales de tu despliegue. Cada uno es un sitio donde puedes acabar desplegando en siete de ocho. Automatizarlo no es elegancia: reduce drásticamente el riesgo de dejar nodos inconsistentes.
- Averigua quién puede parar la producción y con qué mecanismo. Si no hay una forma preparada de cortar, o la respuesta incluye la palabra «depende», ya tienes el trabajo de esta semana.
- Cuenta las alertas de la última semana y cuántas provocaron una acción. Si la proporción es mala, el problema no es que falten alertas: es que sobran.
Y una regla general que sale gratis: una bandera de configuración nunca se recicla. Se crea una nueva. Los nombres son baratos; los cuarenta y cinco minutos de Knight Capital no.
(La próxima vez que alguien diga «total, es solo copiar el fichero en producción», recuerda que eso es exactamente lo que se hizo ese día, y que salió bien en siete de cada ocho intentos.)
Preguntas frecuentes
¿Qué ocurrió exactamente en Knight Capital el 1 de agosto de 2012?
Durante los primeros cuarenta y cinco minutos de la sesión bursátil, el sistema de enrutado de órdenes de la firma ejecutó más de cuatro millones de operaciones erróneas sobre 154 valores: una posición larga de unos 3.500 millones de dólares en 80 de ellos y una corta de unos 3.150 millones en los 74 restantes. Según el expediente de la SEC, el cierre de esas posiciones supuso una pérdida superior a los 460 millones de dólares, por encima de la capitalización bursátil de la propia compañía en aquel momento. Las primeras informaciones de prensa manejaron una cifra algo menor, en torno a los 440 millones.
¿Cuál fue la causa técnica del incidente?
El despliegue del componente nuevo, iniciado por fases el 27 de julio de 2012, se completó en siete de los ocho servidores de producción, sin que un segundo técnico revisara el trabajo ni existiera un procedimiento escrito que lo exigiera. La funcionalidad se activaba mediante una bandera de configuración empleada años antes para habilitar Power Peg, un módulo de pruebas sin uso desde al menos 2003 y nunca eliminado. En el servidor que no recibió el código nuevo, esa bandera activó el módulo antiguo, cuyo contador de control acumulado había sido desplazado a otro punto del sistema en 2005.
¿Por qué empeoró la situación al revertir el despliegue?
El equipo identificó el despliegue reciente como causa probable y desinstaló el código nuevo de los siete servidores donde sí se había aplicado. Al hacerlo, los ocho quedaron ejecutando la versión anterior mientras la bandera de configuración seguía activada, de modo que el módulo obsoleto pasó a ejecutarse en toda la granja en lugar de en una sola máquina. Es un ejemplo de reversión aplicada antes de comprender el mecanismo del fallo.
¿Qué es la fatiga de alertas y cómo influyó en este caso?
Es la pérdida de capacidad de reacción que se produce cuando un sistema emite avisos de forma tan frecuente o indiscriminada que dejan de percibirse como excepcionales. Antes de la apertura del mercado, un sistema interno de Knight envió 97 mensajes de correo que mencionaban el enrutador de órdenes y describían un error concreto, «Power Peg disabled». No estaban diseñados como alertas, sino como notificaciones del mismo tipo que se emitían a diario, y la SEC recoge que el personal no solía revisarlas. El aviso llegó y no lo leyó nadie.
¿Qué medidas evitan un fallo de este tipo en sistemas más pequeños?
Retirar de forma controlada el código y las banderas que dejan de usarse, en lugar de limitarse a desactivarlos: revisar qué hacen, justificar si siguen siendo necesarios, probar su eliminación y quitarlos. No reutilizar una bandera de configuración para una funcionalidad distinta de la original, porque los nombres nuevos son baratos. Automatizar el despliegue, que reduce drásticamente el riesgo de dejar nodos en estados distintos. Y disponer de un mecanismo de parada preparado de antemano, con criterios claros sobre quién lo activa, para que detener el sistema no dependa de improvisar durante la emergencia.
Otras noticias

Windows Me: cuando la fecha se convierte en requisito
El 14 de septiembre de 2000 salió Windows Millennium Edition, mientras Microsoft preparaba la unificación de Windows sobre la rama NT. Traía Restaurar sistema y quitaba el acceso a MS-DOS del que todavía dependían los usuarios avanzados.
Leer más →
La polilla del Mark II ni fue el primer bug ni sabemos quién la encontró
El 9 de septiembre de 1947 alguien pegó una polilla en el cuaderno del Mark II y escribió «primer caso real de un bicho encontrado». Ni bautizó la palabra —Edison ya usaba «bugs» en la década de 1870— ni hay evidencia de que la encontrara Hopper. Lo que sí merece la pena copiar de ese día es el cuaderno.
Leer más →
Google se fundó un 4 de septiembre, pero celebra otro día
Google Inc. se constituyó el 4 de septiembre de 1998 para poder cobrar un cheque extendido a una empresa que no existía. PageRank ganó porque medía algo que el dueño de la web no controlaba directamente: los enlaces de otros. Y en cuanto se supo, empezó a medirlo peor. Se llama ley de Goodhart.
Leer más →El blog, día a día
¿Te ha resultado útil o quieres comentar algo?
Hablemos →