Dos webs de 2000 que no enseñaba primero
Dos de las primeras webs en las que trabajé fueron las de dos clubs de alterne de Donostia, en el año 2000. Siguen en la Wayback Machine con sus tablas y planos de más de 300 KB. La página que diría si las enseñábamos, no: se abría desde JavaScript y no tiene ni una captura.
Hace unas semanas me dio por buscar en la Wayback Machine dos webs que hice hace más de veinticinco años. Esperaba no encontrar nada.
Están las dos. Enteras, con sus botones, sus tablas y sus JPEG de doscientos kilos.
Eran las webs de dos clubs de alterne de Donostia.
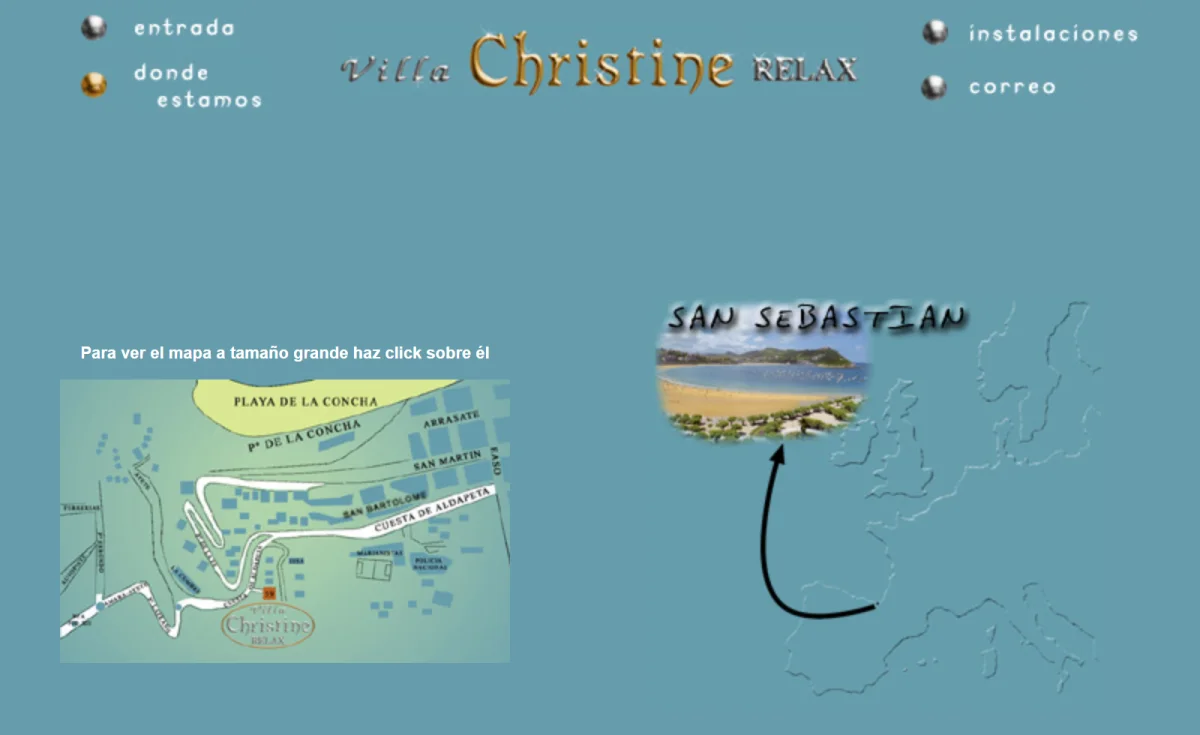
La página de «dónde estamos» de una de ellas, servida hoy por el Internet Archive y vista a 800 × 600, que es la resolución para la que estaba hecha. Captura del sitio archivado en 2001, reproducida a título de cita; recortada por abajo para no reproducir la dirección y el teléfono.
Ngrupo, que venía de «en grupo»
Para situar aquello hace falta un poco de contexto.
Yo venía de una empresa que se llamaba Good Wave, y de allí salimos varios. Los que salimos montamos otra: Ngrupo Diseño, una comunidad de bienes con oficina en la calle Isabel II, en San Sebastián. Éramos cinco socios.
El nombre venía de «en grupo». Lo propuso otro de los socios y lo votamos. El logotipo lo dibujé yo, y también lo votamos: eran cinco piezas, una por cada uno.
Cuento esto porque durante años he contado la historia de estas webs diciendo «cuando era freelance», y no es verdad. No estaba solo. Éramos cinco tíos jóvenes intentando levantar una empresa, y entre los primeros encargos que entraron estaban estos dos.
Y para lo que quiero contar hoy, mi papel importa. Lo que recuerdo haber hecho yo en las dos es maquetar y programar. Del diseño gráfico, las fotografías, los mapas o el trato con el cliente no tengo un recuerdo suficientemente claro como para adjudicármelos. Yo ponía las tablas y el JavaScript.
Qué se puede saber de aquello sin preguntarle a mi memoria
Bastante más de lo que esperaba, porque las cabeceras HTTP originales se archivaron junto con las páginas.
La portada de begonarelax.com tiene una fecha de modificación en el servidor: 12 de septiembre de 2000. Una de sus páginas interiores, el 11. Los ficheros de christinerelax.com están fechados el 4 de diciembre de 2000, y su portada figura como modificada el 3 de enero de 2001.
Conviene decir qué significa ese dato. Es la fecha que comunicaba el servidor, y puede arrastrar la de un fichero copiado de otro sitio: es una pista sobre cuándo se trabajó en los archivos, no una partida de nacimiento de las webs. Lo que sí dicen las capturas es que las páginas ya existían cuando pasó el rastreador.
Y hay una firma que no deja lugar a dudas sobre de quién eran. La portada de Begoña Relax lleva esto en la cabecera:
<META NAME="Author" CONTENT="Ngrupo Diseño">
Christine Relax no lleva esa etiqueta, pero tiene rastros que me resultan familiares: el mismo código. La misma función rollover() de siete líneas, carácter por carácter. El mismo spacer.gif de 346 bytes, byte a byte el mismo fichero que usábamos también en nuestra propia web. La misma frase en la esquina, «Esta web está optimizada para una resolución 800x600». La misma manera de organizar las carpetas.
Nada de eso es exclusivo: un rollover() corto y un spacer.gif circulaban de mano en mano. Pero todo junto cuadra con lo que recuerdo, y más de veinticinco años después uno reconoce su letra en el HTML.
Cómo era hacer esto en el año 2000
Tablas anidadas dentro de tablas. spacer.gif, que era un GIF transparente de un píxel que se estiraba con width y height para obligar a las tablas a quedarse donde queríamos. Estilos en el <head>. Y los rollovers, que eran el efecto de la casa: precargabas dos JPEG por botón, uno apagado y otro encendido, y los intercambiabas con JavaScript al pasar el ratón.
Christine Relax estaba en español y en francés —la frontera está a veinte kilómetros— y avisaba de que iba optimizada «para 800x600 y navegador Internet Explorer 4.0 o superior». Nuestra propia web era peor todavía: si el navegador no era Explorer, te echaba a una página aparte con window.location.replace().
No lo cuento para reírme. Lo cuento porque era lo que había, y porque con esas herramientas se resolvían problemas de negocio de verdad.
El problema de verdad era cómo llegar
Esta es la parte que no me esperaba al abrir el archivo, y es la que me parece más interesante.
Si miras la estructura de begonarelax.com, la sección más trabajada con diferencia no son las fotos ni los textos. Es cómo llegar. Hay una página por zona de la ciudad —Intxaurrondo, Gros, Garbera, Marrutxipi—, cada una con su plano.
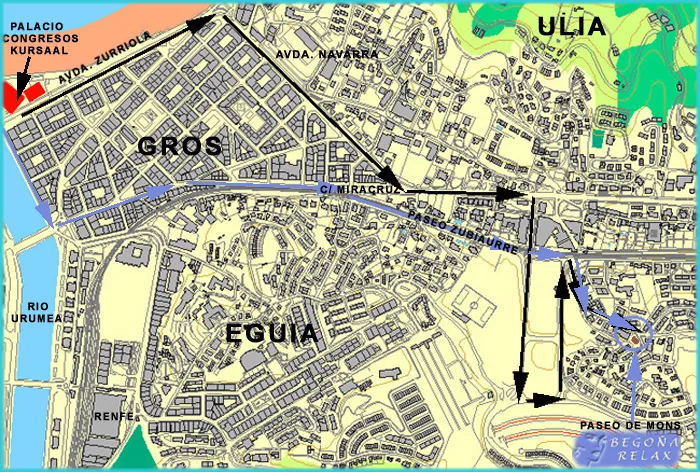
Uno de los planos de begonarelax.com: el recorrido desde el Kursaal, con las flechas dibujadas encima. Captura del sitio archivado en 2002, reproducida a título de cita. La base cartográfica es de origen no identificado; las anotaciones son del propio sitio.
Porque hay que recordar contra qué se estaba trabajando. Google Maps no existía: llegó en febrero de 2005, más de cuatro años después. Si tu negocio estaba en un barrio al que la gente no sabía llegar, lo más claro era dibujarlo.
Y en estos dos casos cada cliente llevaba el suyo. Se ve comparándolos, porque resolvieron el mismo problema de maneras que no se parecen en nada. El de Christine Relax, el de la primera imagen de este artículo, es un plano ilustrado a mano: las calles rotuladas una a una, la Concha en amarillo y el logotipo del local marcando el sitio. El de Begoña Relax parte de una base cartográfica digital —huellas de edificios, curvas de nivel, la A8— y le pinta encima el recorrido con flechas.
Cada local necesitaba su propio plano y sus propias indicaciones. Este es el de la página de Garbera, en Intxaurrondo:
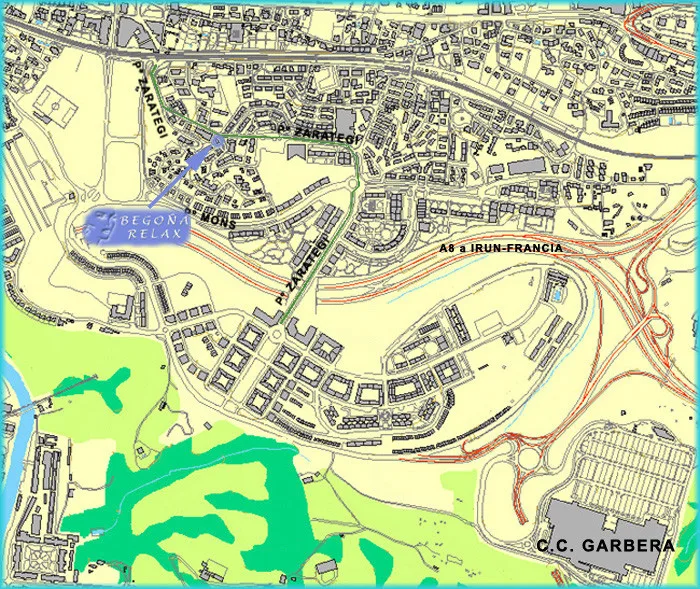
El mismo recurso en la página de Garbera. 700 × 589 píxeles y 363.718 bytes. Captura del sitio archivado en 2001, reproducida a título de cita.
Trescientos sesenta y tres kilobytes. Para un dibujo de líneas y colores planos.
Aquí sí hubo un error de oficio, y es nuestro: eso tenía que haber sido un GIF. Un mapa dominado por líneas y colores planos es un candidato claro para GIF, y justo el caso en el que JPEG trabaja peor.
Y hay una manera de enseñar cuánto mal, porque el fichero sigue ahí. Casi todo el plano son superficies de color plano —el amarillo del suelo, el gris de los edificios, el verde del monte, el rojo de las carreteras— y el rótulo del local. Ese JPEG tiene del orden de ciento setenta mil colores distintos. La inmensa mayoría no los dibujó nadie: son la suciedad que JPEG inventa alrededor de cada línea al comprimir algo para lo que no está pensado.
Cuánto habría pesado en GIF no lo puedo saber: reconvertir ahora el JPEG no sirve, porque el GIF tendría que codificar también toda esa suciedad, y el original limpio no lo tengo. Me quedo con el otro dato: unos ciento setenta mil colores en una imagen hecha casi entera de líneas y color plano.
Puestos a echar la cuenta, y que quede claro que es una estimación teórica y no algo que midiéramos entonces: 363.718 bytes son unos 2,9 millones de bits, y un módem de 56k daba, en el papel, 56.000 bits por segundo. Salen unos cincuenta y dos segundos. En el papel. Los módems de verdad casi nunca llegaban a su número, así que en la práctica sería bastante más.
Algo hicimos bien, para ser justos: los planos grandes iban detrás de una miniatura y solo se descargaban si hacías clic. Pero el que hacía clic esperaba.
Miro eso ahora y no siento vergüenza técnica. Siento el reconocimiento de alguien que estaba aprendiendo con lo que tenía delante, que no sabía todavía cuándo tocaba GIF y cuándo tocaba JPEG, y que lo aprendió más o menos así.
Las fotografías
El otro problema era el material.
Lo que nos daban no siempre servía para una web. Y en algún momento, ante la falta de imágenes que se consideraran adecuadas, llegaron a proponernos que las sacáramos de revistas. Playboy, por ejemplo.
No recuerdo en cuál de los dos proyectos pasó. No recuerdo quién lo dijo exactamente. Y no recuerdo si acabamos usando alguna fotografía de esa procedencia.
Así que no lo voy a afirmar, ni en un sentido ni en el otro. Ya me pasó con el virus que se llevó el código fuente de un proyecto entero: nunca supe cuál era, y elegir uno por parecido histórico habría sido inventarme un dato para que la historia quedara más redonda. Aquí igual.
Lo dejo donde está, que es donde tiene gracia: alguien, en una oficina de Donostia, alrededor del año 2000, propuso resolver un problema de fotografía yendo al quiosco.
Doce años sin tocar un byte
Un último dato del archivo, porque me dejó parado.
La portada de christinerelax.com figura como modificada el 3 de enero de 2001. El Internet Archive la capturó por primera vez en febrero, y a partir de julio la volvió a capturar decenas de veces durante los años siguientes.
El fichero es idéntico hasta julio de 2013. No parecido: idéntico. La misma huella digital doce años seguidos. En 2013, con los móviles ya en todas partes, aquella portada seguía avisando de que estaba optimizada para 800×600 y para Internet Explorer 4.
He escrito antes sobre las webs que nadie toca hasta que hay que tocarlas. Doce años sin que cambie un solo byte puede ser dejadez. O puede ser otra cosa: una web que hizo su trabajo, no volvió a molestar a nadie y por eso nadie se acordó de ella. Cuesta decidir si eso es un fracaso del oficio o el mayor elogio que le pueden hacer a un trabajo.
Y ahora lo que recuerdo, que es más flojo
El archivo permite comprobar buena parte de los detalles técnicos. Lo que recuerdo de cómo vivía aquellos encargos es bastante menos firme.
Lo que recuerdo es que yo sentía aquellos clientes como un poco tabú. No en el trato con ellos —eran clientes normales, con sus reuniones, sus prisas y sus facturas— sino en cómo contaba nuestro trabajo hacia fuera.
Yo tenía la sensación, y era mía, de que asociarnos demasiado en público con ese tipo de negocio podía pasarnos factura con otros clientes que queríamos conseguir. Nadie me lo dijo. No recuerdo una reunión, ni una votación —y mira que en Ngrupo votábamos hasta el logotipo—, ni una política, ni una conversación. Recuerdo una sensación.
Y de ahí sale la frase que resume esto mejor de lo que yo sabría: hice aquellas webs, y no eran las primeras que enseñaba.
Fíjate en lo que esa frase no dice. No dice que las escondiera. No dice que las quitara de ningún sitio. Dice que cuando había que elegir qué enseñar para conseguir el siguiente cliente, no eran las que me venían a la cabeza.
Fui a comprobarlo, y aquí viene lo bueno
Porque después de más de veinticinco años uno ya no se fía de su propia memoria, y esto se podía mirar. Ngrupo tuvo web propia, ngrupo.com, y el Internet Archive la tiene desde el 1 de marzo de 2001.
Ahí está. Ocho botones: quiénes somos, diseño, web hosting, comercio, multimedia, clientes, internet y correo. Capas que aparecían al pasar el ratón con textos que hoy dan una ternura considerable —«Ngrupo es una empresa joven con iniciativa»—, y la dirección de la oficina al pie.
Y el botón de Clientes, con su frase preparada: «Estas son algunas de la empresas que han confiado en Ngrupo, para posicionar su imagen en internet». Con la errata incluida.
Ese botón abría una ventana. Así:
<a href="#" onClick="nuevaventana('clientes.html','','width=350,height=350,left=0,top=175')">
Léelo despacio. El enlace de verdad, clientes.html, no está en el href. El href es una almohadilla. La dirección real vive dentro de un onClick.
Y clientes.html no está archivada. Ni una sola captura, en veinticinco años. La página de al lado, que sí colgaba de un href normal, se archivó a la primera.
No puedo demostrar que una cosa sea la causa de la otra —no sé qué hacía exactamente con el JavaScript el rastreador que pasó por allí en 2001—, pero es la explicación que encaja con lo que quedó y con lo que no.
O sea: el archivo conservó las webs que hicimos y perdió justo la lista de las que enseñábamos. Y es posible que la perdiera por una decisión nuestra, en una línea de código, tomada sin tener ni idea de que estábamos decidiendo nada.
Así que no puedo responder a mi propia pregunta. No sé si Begoña Relax y Christine Relax estaban en aquella ventana de 350 por 350 píxeles. No sé si las quitamos, si nunca se plantearon, o si estaban tan tranquilas entre las demás y lo que yo recuerdo como discreción era solo incomodidad mía.
Y he llegado a la conclusión de que es mejor no saberlo, porque la duda es más honesta que cualquiera de las dos respuestas. Si apareciera esa página y no estuvieran, me sentiría muy listo y seguiría sin saber por qué no estaban. Y si aparecieran, tendría que aceptar algo bastante más incómodo: que llevo veinticinco años recordando como una decisión lo que a lo mejor fue solo una sensación que nunca llegó a hacer nada.
Lo que sí ha cambiado
Hoy Factor Ideas desarrolla y mantiene, entre otras cosas, una tienda del sector adulto. Lleva años. No me quita el sueño ni me parece que necesite ningún tratamiento especial, y desde luego no es un secreto: el crédito de desarrollo está en el código fuente, como en todas.
Pero tampoco quiero venderme la película de la madurez. Toda empresa que enseña trabajos enseña unos y no otros, y eso no lo he dejado de hacer: ni yo, ni nadie. La página de clientes de cualquiera empieza por «algunas empresas» y la de Ngrupo, en 2001, ya empezaba por «algunas» también. Es una palabra que llevamos veinticinco años escribiendo en el mismo sitio.
Lo que ha cambiado es más pequeño y más aburrido, y es esto: entonces me habría preocupado que alguien atara los cabos. Hoy he escrito el artículo yo.
No sé si eso es haber madurado o simplemente haber acumulado suficiente trabajo detrás como para que un cliente concreto ya no me defina. Sospecho que es lo segundo, que se parece bastante menos a una virtud.
Las fechas de modificación de los ficheros, tal como las comunicaba el servidor, proceden de las cabeceras Last-Modified originales conservadas por el Internet Archive junto a cada captura, no de la fecha de rastreo. Las páginas citadas están en la Wayback Machine: begonarelax.com el 4 de diciembre de 2000, christinerelax.com el 1 de febrero de 2001 y ngrupo.com el 1 de marzo de 2001. Google Maps se lanzó el 8 de febrero de 2005. El cálculo del módem es una estimación teórica sobre 56.000 bits por segundo y no contempla la sobrecarga del protocolo.
Preguntas frecuentes
¿Se puede saber cuándo se hizo realmente una web archivada?
De forma aproximada, y sin fiarse solo de la fecha de rastreo. El Internet Archive conserva junto a cada captura las cabeceras HTTP originales del servidor, entre ellas «Last-Modified»: la fecha en que el servidor consideraba que se había modificado ese fichero. Suele estar más cerca del trabajo real que la fecha en que pasó el rastreador, que puede ser meses posterior, pero es una pista y no una prueba: puede arrastrar la fecha de un fichero copiado de otro sitio o, simplemente, estar mal. Lo que sí es firme es la captura: demuestra que la página existía el día que pasó el rastreador.
¿Por qué hay páginas antiguas que no están en la Wayback Machine aunque el resto del sitio sí lo esté?
Una razón posible, y la que encaja con el caso de la web de Ngrupo, es que la dirección no estuviera en un href convencional sino dentro de JavaScript. Era muy común escribir la navegación como un ancla vacía, con href apuntando a una almohadilla, y poner la URL real dentro de un atributo onClick que abría una ventana emergente. En esa web, clientes.html se abría precisamente así y no tiene ninguna captura, mientras que la página contigua, enlazada de forma convencional, sí se archivó. No es una demostración: no se puede saber a posteriori qué hacía con ese JavaScript el rastreador concreto que pasó por allí, pero es la explicación que encaja con lo que quedó y con lo que falta.
¿Por qué pesaban tanto las imágenes de las webs de entonces?
Muchas veces por elegir mal el formato, no por falta de compresión. JPEG está pensado para fotografías, con transiciones suaves, y trabaja mal con dibujos de colores planos y bordes duros: introduce ruido alrededor de cada línea, de modo que un dibujo con unas pocas decenas de colores reales acaba conteniendo decenas de miles. Ese ruido no solo se ve: también impide después comprimirlo bien en un formato de paleta como GIF, porque hay que codificarlo igualmente. Por eso el daño de guardar un plano o un logotipo en JPEG es en buena medida irreversible, y por eso la comparación honesta no es entre el JPEG y su reconversión, sino entre el JPEG y el original limpio que casi nunca se conserva. Era un error frecuente en los primeros años de la web comercial, cuando aún no estaba interiorizado cuándo tocaba cada formato.
¿Cómo se explicaba llegar a un sitio antes de Google Maps?
Casi siempre, dibujándolo. Google Maps no se lanzó hasta el 8 de febrero de 2005, así que un negocio que dependiera de que la gente supiera llegar solía resolverlo con imágenes: un plano por zona de la ciudad, con el recorrido marcado encima a base de flechas y rótulos, y una página propia para cada uno. Eso convertía la sección de localización en una de las más trabajadas y más pesadas de muchos sitios comerciales, justo cuando el ancho de banda doméstico era el de un módem telefónico.
¿Se puede saber si dos webs distintas las hizo el mismo equipo?
A veces hay una firma, como una etiqueta «Author» en la cabecera. Cuando no la hay, quedan indicios: la misma función de JavaScript carácter por carácter, el mismo fichero auxiliar byte a byte, la misma organización de carpetas y las mismas frases fijas en la interfaz. Por separado no prueban nada, porque en aquella época los fragmentos de código circulaban de mano en mano; juntos, y sumados a otros datos, apuntan a un mismo taller.
Otras noticias

Stop motion: los muñecos que se negaron a quedarse quietos
Hoy es el Día Internacional de la Animación: se celebra por una función de 1892, tres años anterior a la de los Lumière. Escribo de stop motion —cine y también videojuegos—, que me gusta desde los cuadernos de dibujitos en la esquina de la página, y de por qué un oficio puede sobrevivir al taller que lo cierra.
Leer más →
GeoCities: el día que se apagaron 38 millones de páginas
El 26 de octubre de 2009 Yahoo apagó GeoCities y con ella quince años de web hecha a mano: barrios temáticos, contadores de visitas, libros de firmas y GIF de «en construcción». La salvó un grupo de voluntarios con scripts. Ese fue todo el plan de continuidad.
Leer más →
Por qué los malos nunca aciertan a John Wick
Hoy hace doce años del estreno de John Wick. En casa las hemos visto todas, y en algún momento sale la broma: ¿cómo pueden volver a fallar? Pues sí le dan. De crío veía El Equipo A, El coche fantástico y MacGyver con mi hermano Taka y con Vivi, mi madre, y allí el problema no era que fallaran: es que no mataban.
Leer más →El blog, día a día
¿Te ha resultado útil o quieres comentar algo?
Hablemos →