La caída de Outlook, explicada: servidores que se retiran y los que quedan no dan abasto
Desde el jueves 12, Outlook y Exchange Online fallan para muchas empresas. Los mensajes de Microsoft describen un fallo en cascada: servidores que no pasan las comprobaciones de salud, los demás sobrecargados y los recuperados que vuelven a caer. Qué ha pasado y qué puede preparar una empresa.
En este artículo 7 secciones
- Lo que ha pasado, en horas de aquí
- Lo que dice Microsoft, frase a frase
- Cómo se cae un sistema que está diseñado para no caerse
- Una vulnerabilidad de Outlook que no tiene nada que ver
- No es la primera de este año
- Qué puede hacer una empresa que vive en Microsoft 365
- La nube cambia quién arregla la avería
Desde el jueves por la tarde, mucha gente que trabaja con Microsoft 365 no puede abrir su correo. Outlook, en la web y en el escritorio, se queda intentando conectar, y con el correo fallan el calendario y las funciones de Teams, SharePoint y Copilot que dependen de él. Escribo esto el viernes 13 a las nueve de la mañana y todavía no está resuelto.
Actualización del 13 de noviembre, 20:00. Microsoft ya apunta a un origen. En un mensaje que recoge el directo de NBC News, dice que el incidente lo introdujo un problema surgido durante una ampliación anterior de la capacidad de red, que afloró tras un cambio de red reciente, y que fue «un problema técnico no relacionado con ciberataques ni con IA o agentes». Dice también que ha corregido el problema de fondo y que sigue devolviendo el servicio a los clientes y regiones que faltan, poco a poco y comprobando la estabilidad en cada paso. Todavía no lo da por resuelto, y el informe con la causa raíz detallada llegará cuando termine la recuperación.
Así que el cambio de red que «coincide con el inicio del impacto» era algo más que una coincidencia: según Microsoft, fue lo que sacó a la luz un problema que venía de antes. Lo que aún no ha contado es por qué eso hizo fallar las comprobaciones de salud de los servidores, que es la cascada que explica este post.
Actualización del 13 de noviembre, 16:30. Microsoft sigue sin darlo por resuelto, pero el correo está volviendo. La recuperación ha ido por zonas: primero Asia-Pacífico, después Europa y Norteamérica. En España el acceso empezó a volver a primera hora de la tarde, según El Output. Hacia las 15:30, Microsoft decía que las colas de correo se habían reducido mucho y se acercaban a niveles normales, y avisaba de que algunos usuarios todavía pueden tener cortes intermitentes o recibir el correo con retraso, según el directo de NBC News.
La noche fue como la cuento más abajo. Microsoft había congelado todos los despliegues el jueves hacia las 20:00. De madrugada reconoció que uno de los cambios no funcionaba como esperaba y se puso a añadir máquinas virtuales para ganar capacidad, algunas de las cuales se quedaban atascadas, según la cronología de LazyAdmin.
Hay dos cosas nuevas que conviene saber. Varios medios cuentan que Microsoft ha ampliado a 48 horas el tiempo que el correo retrasado puede esperar en sus colas, para que no se pierda; no he encontrado la frase de Microsoft, solo la versión de NBC y El Output. Y la causa sigue sin publicarse. Microsoft dijo que empezaba a deshacer un cambio de configuración de red «que coincide con el inicio del impacto», que no es lo mismo que decir que lo causara, y promete un informe posterior al incidente con la causa raíz y las medidas para que no se repita. Charles Lamanna, vicepresidente ejecutivo de Microsoft, insiste en que no hay indicios de actividad maliciosa. Lo que sigue es lo que escribí a las nueve de la mañana.
Microsoft lo sigue en dos incidentes: EX1550543, el de Exchange Online («los usuarios pueden no poder conectarse a sus buzones por varios métodos de conexión»), y MO1550821, el que recoge el impacto en el resto de Microsoft 365. Afecta a las cuentas de empresa y de centros educativos, que son las que viven en Exchange Online.
Lo fácil sería contar que Outlook se ha caído y que Microsoft está trabajando en ello. Pero los mensajes que Microsoft ha ido publicando, leídos en orden, describen un tipo de avería muy concreto que conviene entender. Si tienes servidores propios, te puede pasar lo mismo a otra escala.
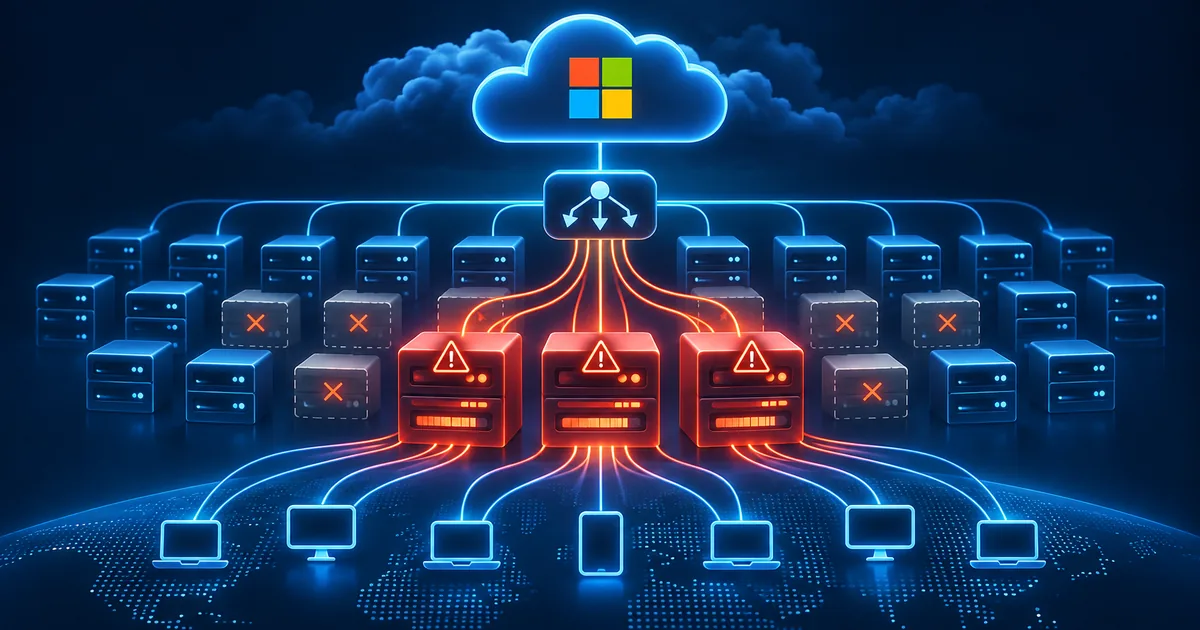
Ilustración generada con IA para este artículo. No representa la infraestructura real de Microsoft.
Lo que ha pasado, en horas de aquí
- Jueves, 17:17. Es la hora de inicio que Microsoft registra para el incidente de Exchange Online.
- Sobre las 18:45. Se disparan los avisos de usuarios, y poco antes de las 19:00 Microsoft lo reconoce en público: problemas para acceder a los buzones «en las Américas».
- Hacia las 19:00. Downdetector, que cuenta quejas de usuarios y no afectados reales, se acerca a 130.000 avisos sobre Outlook. En torno a una hora llegan avisos de 74 países y territorios, según ESdiario.
- Hacia las 19:45. Microsoft amplía el alcance: ya no son solo las Américas, puede afectar a cualquier región.
- Jueves por la tarde y noche. Microsoft cambia la forma en que comprueba si sus servidores están sanos, reinicia los afectados y empieza a deshacer un cambio reciente de configuración de red. Parte de los servidores vuelve.
- Viernes de madrugada. Los servidores recuperados vuelven a dejar de responder en cuanto reciben tráfico. En Australia y Japón, donde ya era viernes laborable, se paran administraciones y empresas: el Gobierno australiano activó un acuerdo con Microsoft para que priorizara su recuperación, según ABC News.
- Viernes, primera hora de Europa. Microsoft informa de «resultados positivos en la estabilidad de los servidores» tras aplicar un parche de configuración en un componente de autenticación y enrutamiento, todavía en una parte de su infraestructura. No da hora de recuperación.
Microsoft dice que no tiene constancia de actividad maliciosa que esté causando el incidente, y promete un informe completo con la causa raíz cuando lo haya mitigado. Hasta entonces, nadie fuera de Microsoft sabe por qué empezó.
Lo que dice Microsoft, frase a frase
Las actualizaciones de la cuenta Microsoft 365 Status y de su panel de estado cuentan una historia que se va corrigiendo a sí misma. Las resumo en el orden en que salieron, con lo que recogieron SecurityWeek, NBC y CNBC:
- Una parte de la infraestructura tiene carga elevada en varias regiones, y la respuesta es repartir las conexiones por el resto de la red mundial.
- Corrección: esa carga no viene de que haya más tráfico. Viene de que varios servidores han dejado de estar disponibles de forma inesperada, y eso sobrecarga a los que quedan.
- Esos servidores están fallando las comprobaciones automáticas de salud. Microsoft valida un método alternativo para hacerlas y una parte vuelve al servicio.
- En los servidores afectados, el proceso que establece las conexiones seguras se satura, y el servidor deja de atender peticiones.
- Los servidores que vuelven pueden dejar de responder otra vez en cuanto reciben tráfico.
- Hay un aumento del volumen de llamadas desde los servicios de enrutamiento hacia los servidores de detrás.
Ninguna de estas frases es la causa raíz. Pero juntas describen un fallo en cascada, y eso sí se puede explicar.
Cómo se cae un sistema que está diseñado para no caerse
Un servicio como Exchange Online no es un servidor: son miles, detrás de unos equilibradores de carga que reparten las conexiones. Para no mandar usuarios a una máquina averiada, el equilibrador pregunta a cada servidor cada pocos segundos si está bien. Es la comprobación de salud (health check). El que no contesta a tiempo sale de la rotación, y su tráfico se reparte entre los demás.
Es un buen mecanismo cuando falla una máquina suelta. Muchos sistemas llevan además frenos para cuando fallan muchas, como no retirar nunca más de cierta proporción a la vez. Cuando no los hay, o no bastan, la cuenta es muy sencilla:
- Tienes 100 servidores trabajando al 60 % de su capacidad.
- Por lo que sea, 30 empiezan a contestar tarde y la comprobación los retira.
- Los 70 que quedan reciben el tráfico de los 100. Pasan al 86 %.
- A ese nivel de carga, algunos de ellos también empiezan a contestar tarde a la comprobación de salud. Salen. Los que quedan suben al 100 %, y así hasta el final.
El mecanismo que protege al sistema de una máquina enferma es el que, cuando enferma una parte grande, saca de la rotación también a las sanas. Cada retirada hace más probable la siguiente.
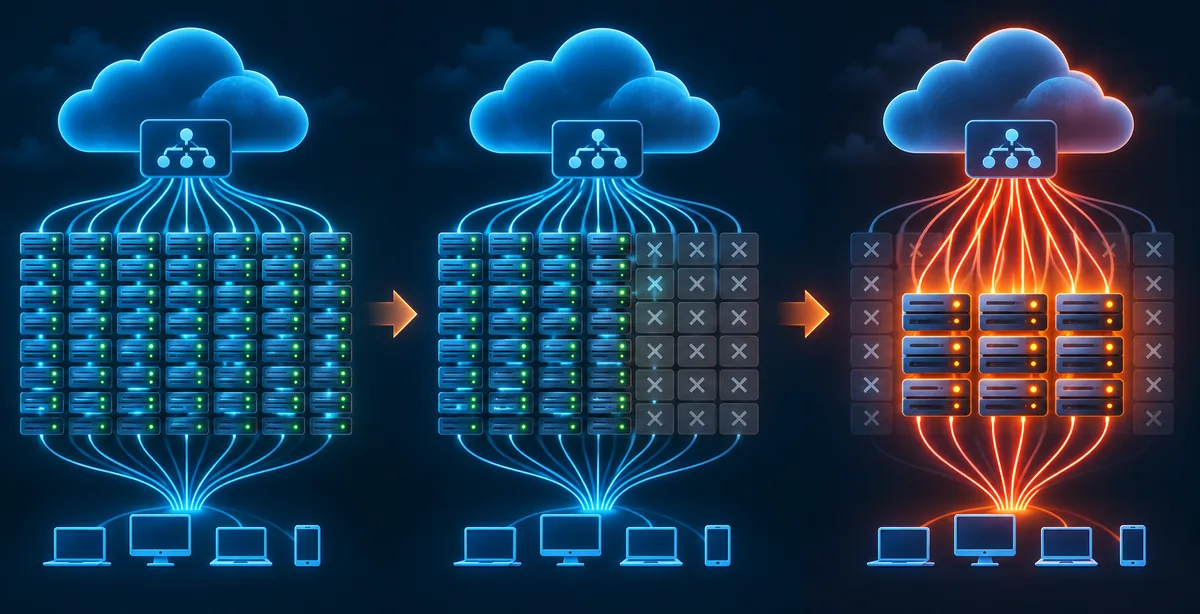
Ilustración generada con IA para este artículo. No representa la infraestructura de Microsoft.
Y entonces llega la parte que Microsoft lleva un día describiendo: arreglas un servidor, lo vuelves a meter y se cae otra vez. Vuelve a un sistema saturado, recibe de golpe su parte de la cola, más las reconexiones de todos los clientes que llevan horas reintentando, y no aguanta. Si encima lo que se satura es el proceso que establece las conexiones cifradas, que suele ser de lo más caro de cada conexión nueva, cada cliente que reintenta pesa más que uno que ya estaba conectado.
Por eso la salida de un fallo así no es «reiniciar todo», sino devolver capacidad poco a poco y con el tráfico contenido, que es lo que Microsoft ha dicho que está haciendo: corregir el comportamiento en unos pocos servidores, comprobar que aguantan y volver a meter tráfico de forma gradual.
Ojo: esto es cómo funcionan en general este tipo de cascadas, y encaja con lo que Microsoft ha contado. No es el diagnóstico de esta. No sabemos qué hizo que los primeros servidores empezaran a fallar. Microsoft ha deshecho un cambio de configuración de red y ha parcheado un componente de autenticación y enrutamiento, pero no ha dicho que ninguno de los dos sea el origen.
La familia de este fallo es conocida. En el post del Día del Sysadmin conté la caída de Facebook de 2021: sus servidores DNS estaban diseñados para retirarse solos cuando detectaban una red enferma, y cuando la red enfermó entera se retiraron todos. Una protección pensada para una avería pequeña agravó una avería grande.
Una vulnerabilidad de Outlook que no tiene nada que ver
Estos días circula, también en LinkedIn, que la caída coincide con CVE-2026-124194, una vulnerabilidad de Outlook que Microsoft corrigió el martes 10 y que ya se estaba explotando. La CISA la añadió ese mismo día a su catálogo de vulnerabilidades explotadas, donde la describe como una acción potencialmente insegura que Outlook ejecuta sin pedir confirmación al usuario, y fija el 24 de noviembre como plazo para parchear.
Son dos cosas distintas, y conviene no mezclarlas:
- La vulnerabilidad está en el programa Outlook instalado en cada equipo. Según los análisis técnicos publicados, que afectan al Outlook clásico de Windows, un mensaje preparado puede hacer que Outlook envíe a un servidor del atacante el hash NTLMv2 de las credenciales del usuario sin el aviso habitual. Se arregla instalando la actualización de noviembre de Office en cada equipo.
- La caída está en los servidores de Microsoft. No se arregla en tu oficina, y que Outlook no conecte no dice nada sobre si tus equipos están parcheados.
Microsoft no ha relacionado una cosa con la otra, y SecurityWeek lo dice expresamente. Lo práctico es no dejar que la caída tape la vulnerabilidad: cuando vuelva el correo, comprueba que los equipos tienen el parche.
No es la primera de este año
El 31 de agosto Exchange Online ya tuvo otra caída grande, el incidente EX1464935: fallos al enviar y recibir correo, errores de autenticación y búsquedas que no funcionaban, con efecto en OneDrive, SharePoint, Teams y Copilot. Microsoft lo atribuyó a problemas en una configuración de autenticación que usan muchos servicios internos de Exchange Online, y no dio por resuelto todo el impacto hasta el 3 de septiembre, según la cronología de BleepingComputer. Dos caídas grandes en poco más de diez semanas.
No lo digo para concluir que Microsoft 365 sea un mal servicio. Montar tu propio servidor de correo para una empresa de diez personas no te va a dar más disponibilidad que eso, y te va a dar mucho más trabajo. Lo digo porque la disponibilidad que te venden es una media, y las medias tienen días malos.
Qué puede hacer una empresa que vive en Microsoft 365
No puedes arreglar los servidores de Microsoft. Lo que sí puedes es decidir antes qué haces mientras esperas.
1. Saber qué depende del correo. No es solo Outlook. Este jueves fallaron el calendario, la programación de reuniones de Teams, funciones de SharePoint y de Copilot y hasta los conectores de Microsoft 365 que usan los asistentes de OpenAI y Anthropic. Si tu CRM, tu herramienta de facturación o tu automatización leen o envían correo a través de Microsoft 365, también se paran. Haz esa lista con calma, no el día de la caída.
2. Tener un canal alternativo decidido de antemano. Un grupo de mensajería, una lista de teléfonos o una cuenta de correo en otro proveedor para avisar a clientes. Con un detalle que se olvida: la agenda de contactos suele vivir en el mismo Exchange que se ha caído. Si el teléfono de tus diez clientes principales solo está en Outlook, el día que falla no lo tienes.
3. Saber que el correo que te mandan no suele perderse. Cuando un servidor de correo no puede entregar un mensaje, por norma lo guarda y lo reintenta durante días antes de rendirse; cuántos depende del servidor que lo envía, y el estándar recomienda al menos cuatro o cinco. Esta caída afecta sobre todo al acceso a los buzones, así que lo normal es que el correo aparezca cuando vuelva el servicio. Lo que sí conviene es avisar a quien espera una respuesta urgente.
4. Saber dónde mirar. El estado oficial está en el apartado Estado del servicio del centro de administración de Microsoft 365 y en la cuenta Microsoft 365 Status. Esta vez el propio centro de administración falló para algunos administradores, y Microsoft tuvo que publicar las actualizaciones por un enlace alternativo. Por eso conviene tener apuntada también la página de estado pública, status.cloud.microsoft, que no pide iniciar sesión. Downdetector sirve para saber si no eres solo tú, no para saber qué pasa.
5. Desconfiar del correo que llega «por la caída». Una caída grande es el momento ideal para un phishing que diga «reactiva tu cuenta de Microsoft 365». Microsoft no te va a pedir la contraseña para arreglar su incidente.
6. Leer el acuerdo de nivel de servicio. El SLA de Microsoft vigente, el de noviembre de 2026, considera caída de Exchange Online justo lo de este jueves: que los usuarios no puedan enviar ni recibir correo con Outlook en la web. Lo mide en minutos por usuario afectado, y si en el mes la disponibilidad baja del 99,9 % —unos 43 minutos—, prevé abonar el 25 % de la cuota; por debajo del 99 %, el 50 %, y por debajo del 95 %, el 100 %. Pero no es automático: hay que reclamarlo a soporte con la descripción del incidente, las horas y los usuarios afectados, y antes de que acabe el mes siguiente. Para esta caída, hasta el 31 de diciembre. Y en cualquier caso compensa la cuota, no el día de trabajo perdido.
La nube cambia quién arregla la avería
Lo que ha pasado este jueves no es un argumento contra la nube. Es un recordatorio de lo que la nube cambia y de lo que no. Antes, cuando se caía el servidor de correo de la oficina, el problema estaba en un armario al fondo del pasillo y lo arreglaba alguien con nombre y apellido. Ahora está en un centro de datos a cientos de kilómetros, se arregla mejor y más rápido de media, y lo arregla gente que no sabe que existes.
Lo que no ha cambiado es la pregunta que hay que hacerse antes de que pase: si mañana no hay correo durante un día entero, ¿qué hacemos? Quien la tenía contestada el jueves pasó una tarde incómoda. Quien no, se pasó la tarde mirando la pantalla.
Actualizaré el post cuando Microsoft dé el incidente por resuelto y cuando publique su informe con la causa raíz.
Preguntas frecuentes
¿Qué ha pasado con Outlook el 12 y 13 de noviembre de 2026?
Desde el jueves 12 de noviembre por la tarde (Microsoft registra el inicio a las 17:17, hora de España), muchas cuentas de empresa y educación de Microsoft 365 no pueden conectarse a sus buzones de Exchange Online. Afecta a Outlook en la web y en el escritorio, y a funciones que dependen de Exchange en Teams, SharePoint y Copilot. Microsoft lo sigue como EX1550543 y MO1550821, y el viernes por la tarde el servicio volvía por regiones, sin que Microsoft lo diera todavía por resuelto.
¿Cuál es la causa de la caída?
Según Microsoft, el incidente lo introdujo un problema surgido durante una ampliación anterior de la capacidad de red, que afloró tras un cambio de red reciente; el informe con la causa raíz detallada llegará cuando termine la recuperación. Ha explicado que varios servidores fallaban las comprobaciones automáticas de salud y dejaban de estar disponibles, que eso sobrecargaba a los restantes, que el proceso que establece las conexiones seguras se saturaba y que los servidores recuperados volvían a dejar de responder al recibir tráfico. Ha deshecho un cambio de configuración de red y ha parcheado un componente de autenticación y enrutamiento, sin decir que ninguno sea el origen.
¿Ha sido un ciberataque?
Microsoft dice que no tiene constancia de actividad maliciosa y que fue un problema técnico no relacionado con ciberataques. Tampoco lo ha relacionado con CVE-2026-124194, una vulnerabilidad de Outlook clásico para Windows corregida el 10 de noviembre que sí se estaba explotando, y que se arregla instalando la actualización de Office en cada equipo.
¿Se pierde el correo que me envían durante la caída?
Normalmente no. Cuando un servidor de correo no puede entregar un mensaje, lo guarda y lo reintenta durante días antes de rendirse; cuántos depende del servidor que lo envía, y el estándar recomienda al menos cuatro o cinco. Esta caída afecta sobre todo al acceso a los buzones, así que lo habitual es que el correo aparezca cuando vuelve el servicio.
¿Qué puede hacer una empresa ante una caída de Microsoft 365?
Arreglarla, nada: está en los servidores de Microsoft. Lo útil se prepara antes: saber qué herramientas dependen del correo, tener un canal alternativo y los contactos clave fuera de Outlook, saber dónde mirar el estado oficial, desconfiar de correos que se aprovechan de la caída y saber que los abonos del acuerdo de nivel de servicio no son automáticos: hay que reclamarlos a Microsoft antes de que acabe el mes siguiente al incidente.
Sigue leyendo

Lo que se cuela del WAF: un ataque DDoS visto desde PHP-FPM
Un DDoS con 650 procesos de PHP y unos 20 GB de RAM sirve para explicar por qué filtrar tráfico en Cloudflare es solo una parte de la defensa, y qué capas frenan lo que se cuela del WAF antes de que llegue a PHP.
Leer más →
IA en producción (3/6): tu copia está dentro de la explosión
La empresa a la que un agente le borró producción se salvó por «una copia de la copia, una redundancia no planificada». Por qué las instantáneas no son copias, por qué la réplica replica también el DELETE y por qué lo único que demuestra que tienes una copia es haberla restaurado.
Leer más →
El servidor estaba vivo, pero no contestaba
Estoy fuera y uno de mis servidores decide que necesita una placa base nueva. OVHcloud la cambia, las MAC cambian con ella y me lo devuelve en Rescue Mode: discos sanos, RAID sano, Ubuntu entero y una configuración de red que espera una tarjeta que ya no existe. El arreglo cabía en una línea de YAML.
Leer más →¿Te ha resultado útil o quieres comentar algo?
Hablemos →